Viser opslag med etiketten opgave. Vis alle opslag

september 26, 2006

Litteratur so far..

Ja, jeg har p.t. fundet følgende litteratur, men det er hovedsageligt fra tidligere tiders noter & litteraturlister:

  • Akerlof, G. A. (1970): "The Market for 'lemons': Quality Uncertainty and the Market Mechanism". Quarterly Journal of Economics 84 (3), 488-500.
  • Andersen, E. S. (2005): Brugeren til diskussion. bibliotekspressen 1, 2005, 18-19
  • Andersen, J. (2003): Information literacy: Hvad skal man vide for at søge efter information biblioteksarbejde nr. 66, 2005, s. 59-68
  • Belanger, Teerry (2003): Lunacy and the arragenment of books. New Castle, Dalaware, Oak Knoll Press. 33-56.
  • Dervin, B. (2003): Sense-making methodology reader : selected writings of Brenda Dervin. Cresskill New Jersey, Hampton Press Inc.
  • Emerik, L. (1981): Genreopstilling af skønlitteratur i folkebibliotekerne. Biblioteksarbejde, årg 4, nr. 7.
  • Lee, hur-li & Olson, Hope A. (2005): Hierarchical Navigation: An exploration of Yahoo! Directories. KNowledge Organisation 32, 2005, nr. 1, 10-24
  • Nielsen, J. (1993): Usability Engineering. London, Academic Press
  • Mai, N. E. (2005): Analysis in indexing: document and domain centered approaches. Information Processing and Management. Nr. 41(3). 599-611.
  • Pedersen, N. M. L. (2006): Wikipedia: kan man stole på hvem som helst?. RetorikMagasinet nr. 60/2006,
  • Schade, H. F. (2006): Viden er noget rod - alt er diverse bibliotekspressen 1, 2006, 12-14
  • Shoham, S. (2000): Library classification and browsing : the conjuction of readers and documents. Brighton, Sussex Academic Press.
  • Tillet, B. (2005): FRBR and Cataloging for the Future. Cataloging & Classification Quarterly. 39 (3/4) 197-205
Jeg håber på mere snarligt...

september 24, 2006

Tid til seriøsitet..

Så, nu har jeg "smidt hvalpefedtet", "raset ud", "kogt mine hjerneceller over", og brainstormet alt hvad jeg formåede, af vilde sære ideer. Men nu er det blevet tid til noget dokumentsøgning.

Jeg har stadig ikke 100% styr på hvad jeg vil skrive om, dvs. jeg har ingen problemformulering endnu. Men jeg har netop læst mine gamle noter fra 4. semester igennem, og har nu en ide om hvad jeg skal gøre for at få et overblik over de problemstillinger jeg synes er relevante, og hvilken litteratur jeg nogenlunde vil arbejde med. Min indgangsvinkel bliver derfor:

  1. Er den funde litteratur interessant, så er den relevant for min opgave
  2. Er den funde litterater læst før OG interessant, er den super relevant :)

Jeg tror jeg vil poste mine "fund" af literatur både her, men også på en littereraturliste på min twiki-side.

Håber jeg finder noget ..

september 18, 2006

Brainstorm: "Automatiske klynger"

! Denne post er under konstant redigering. Der advares om at der forefindes grov misbrug af ord udenfor kontekst, og i forkert betydning - som meget muligt vil få enhver på Danmarks Biblioteksskole til at krænge tæer.

"Automatiske klynger"
Denne tekst er tænkt som en del-konklussion til en evt. opgave, dvs. et del-område, der muligvis kan inkluderes. Evt. bruges til at komme med en pointe i min endelige opgave. Referencer, citater og andet er ikke vedlagt.

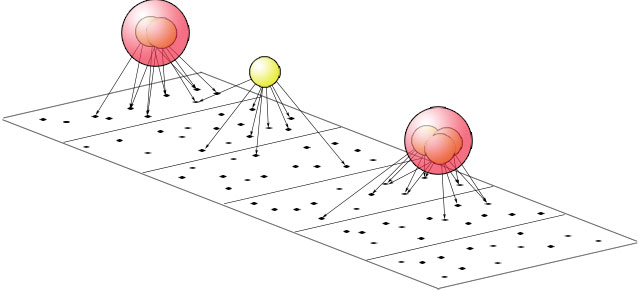
Jeg har i noget tid, baseret på begrebet "link-clusters", tænkt på hvorvidt det måtte være muligt at lave noget lignende med tags - dvs. tags-clusters. Grundideen er forholdsvis simpel, et tag (T2) peger en mængde sider (M1) og et andet tag (T2) peger på en anden mængde sider (M2). Hvis fællesmængdes af M1 og M2 overstiger en hvis procentdel af enten M1 eller M2, vil disse to tags være relateret. Det er et forsøg der som sådan vil kunne udføres på del.icio.us og blogger uden de helt store problemer. Jeg forestiller mig følgende illustration:

Ovenstående ser vi en falde (det kan være to del.icio.us profiler's der er "slået sammen"), samt seks tags. Tags er gule, links prikker, pilene betyder at et tag er "hæftet" på et link, og de røde bobler viser hvor der er en sandsynlighed for at vi faktisk har med det samme begreb at gøre. Reelt set, kan vi have at gøre med forskellen mellem ordene "Bibliotek" og "Biblioteker", men også "Bibliotek" og "Library". Vi burde altså, ud fra hvilke tags der er blevet giver til et bestemt link, kunne automatisk lave en form for "begrebsklynger".

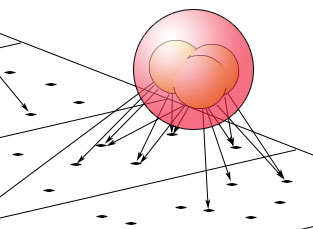
Ved et nærbillede af en begrebsklynge, kan man se hvordan de tre tags inde i klyngen, deler mange sider imellem sig:


Det interessante ved hele denne tilgang til klynger er, at man tager udgangspunkt i tags og ikke i links.

Brainstorm: "Folksonomi eller hysteri"

! Denne post er under konstant redigering. Der advares om at der forefindes grov misbrug af ord udenfor kontekst, og i forkert betydning - som meget muligt vil få enhver på Danmarks Biblioteksskole til at krænge tæer.

"Folksonomi eller hysteri"
Denne tekst er tænkt som en del-konklussion til en evt. opgave, dvs. et del-område, der muligvis kan inkluderes. Evt. bruges til at komme med en pointe i min endelige opgave. Referencer, citater og andet er ikke vedlagt.

Med udgangspunkt i del.icio.us, kan man se at brugere tagger de samme sites vha. forskellige ord. Tager vi Danmark Biblioteksskoles hjemmeside, er denne blevet tagget som:

  • Bibliotekar (3)
  • Uddannelse (2)
  • Biblioteker (1)
  • Biblioteksskolen (1)
  • DB (1)
  • Education (1)
  • Biblioteksskole (1)
  • Kurser (1)
Dette er jo som sådan et mønster vi kan forvente, men nu tillader vi os at tilføje endnu to tags, fra en arkitekstuderende:

  • DahlerupVilhelm (1)
  • PostmodernistiskSendepremisme (1)
Jamen, det kan vi jo som sådan godt tillade, det er jo ikke noget problem. Joeh, som sådan er det, fordi nu ser man pludselig hvad det reelt er man gør når man tagger. Man laver nemlig ikke emneord, eller siger noget om aboutness. Man tagger ud fra use eller hvilket purpose, som man har med den pågældende side. Dvs. Tags er purpose og skal derfor ses i kontekst med hvilket brug man gør sig af dem. Det er tydeligt, når vi ser den arkitektstuderende; www.db.dk handler jo ikke om Dahlerup Vilhelm, eller Postmedernistisk Sen-depremisme, men det den use han har fundet i tagging - han bruger til sit eget purpose. Aha, vi har altså nu kan konkludere er:

  1. Tagging er ikke det samme som emneord
  2. Grunden til at tagge er ikke den samme
Vi ved allerede (fra tekster i timen) at der er problemer med tagging fordi man kan have forskellige indfaldsvinkler til hvordan man tagger. Nogle skriver bibliotekskole, andre bibliotekskolen, helt andre blot DB. Men udover der mangler en fælles diskurs, "kontrollerede" emneord, så mangler der også fælles forudsætninger og indfaldsvinkler.

Hvis vi nu forestiller os at der bliver den klassiske klokkeform (normalfordeling) på mængden af tags af http://www.db.dk - så vil vi opleve tags kommer til at ligge således:

De blå områder er områder der angiver tags som rigtig mange der har tagget denne side med. Dvs. det er f.eks. "Bibliotek", "Bibliotekskole", "Bibliotekskolen" og alt i den dur. Indtil den første sorte streg er dette zone A - den populære tag-zone. Næste zone (B) er lidt mere perifær, her ser vi ord som "kurser", "kantine", "forlag". I zone (C) er de mere alternative, men få, måder at se på http://www.db.dk. F.eks. veterinærtilsynets tags, tags til DSR, computere der benyttes på DB, og de andre interressegrupper, f.eks. arkiteksstuderende. I zone (D) finder vi hovedsageligt slåfejl og vildledelser. I hver zone kan der findes ord der er stavet forkert, som burde høre til den tidligere zone. F.eks. kan der i zone D, C og B findes fejl-stavede ord som burde være i A, men pga. populære stavefejl er endt i andre zoner. Disse stavefejl medregnes til zone A.

Pointen med denne illustration er, at det pludselig åbner op for spørgsmålet: hvordan sikrer man at brugeren kun ser tags ud fra brugerens eget viewpoint. Som arkitektstudrende er det mig fuldstændig ligegyldigt, at Danmarks Biblioteksskole også tilbyder kurser, uddannelse og kantiner. Jeg er kun interesseret i artikekturen. Det der så er sket med vores "tagfællesskab" er, at jeg er blevet fremmedgjort overfor de tags der sat på http://www.db.dk - de er falder udenfor min bevæggrund.

Dette tillader jeg mig nu at generalisere til én specifik regel: Al generalisering vil ødelægge det subjektive præg, for det enkelte subjekt. Dette gælder ikke kun i DK5, Thesaurier, citater, abstracts, referater, emneord, anmeldelser og alt andet der er generaliseringer - men sørme, det gælder også for den brugerskabte generalisering.

Del.icio.us - slaget er tabt!

september 08, 2006

Brainstorm: "Mulige emner"

! Denne post er under konstant redigering. Der advares om at der forefindes grov misbrug af ord udenfor kontekst, og i forkert betydning - som meget muligt vil få enhver på Danmarks Biblioteksskole til at krænge tæer.

Overskrifter der overvejes til andre emner
"Den Brugerskabte Tesauri"
"(indsæt buzz ord her) af klyngedannelser"
"Making sense of tagging"
"Web2.0 & Usability"

Brainstorm: "Når indhold skaber struktur"

! Denne post er under konstant redigering. Der advares om at der forefindes grov misbrug af ord udenfor kontekst, og i forkert betydning - som meget muligt vil få enhver på Danmarks Biblioteksskole til at krænge tæer.

"Når indhold skaber struktur"
Denne tekst er tænkt som en del-konklussion til en evt. opgave, dvs. et del-område, der muligvis kan inkluderes. Evt. bruges til at komme med en pointe i min endelige opgave. Referencer, citater og andet er ikke vedlagt.

Man skal forestille en opgave der består af at udtænke en simpel tesauri - lad os sige for en zoologisk have. I et sådan tilfælde vil man skabe en struktur og derefter "placere" de dokumenter man måtte have i denne struktur. Strukturen vil bygges op omkring hvilken information man forventer der kommer i selve tesaurien - man køber også ind efter de samme regler/forventninger som tesaurien er bygget op omkring. Strukturen dikterer indholdet. Den pågældende tesauri bliver et udtryk for, de dokumenter den kommer til at indeholde.
Med tagging er det lige omvendt. Vi har indholdet, og ud fra det skaber vi vores egen struktur - en tesauri uden NT/BT - kun RT'er. Dvs. vi skaber vores strukture omkring det indhold vi har. Det kan illustreres med disse billeder, hvor sort er inhold, stregerne er relationer og blåt er strukturen:

Her en klassisk tesauri, hvor strukturen bliver fastsat - den kan ses som den blå ramme. Dette er altså den forventede struktur på vores information, de dokumenter der senere skal indpasses i vores tesauri og de dokumenter der skal indkøbes på baggrund af strukturen:

Men når vi så begynder at indsætte dokumenter, kan det ske at vores tesauri ikke helt passer med virkeligheden. Det kan faktisk være at den zooligiske have aldrig rigtig fik købt de gråspættede pelikaner, eller også viser det sig, at dele af tesaurien var alt for specificeret. Derfor, når vi "fylder den op", vil der ske følgende:


Vi har tomme områder - og det skyldes enten en fejlbedømmelse af den kommende data ELLER et forkert brug af den pågældende tesauri. Men tingene ser helt anderledes ud, når vi vender os mod tagging - her kommer indholdet først, og strukturen senere, vi ville altså reelt opnå at få:


- at indhold medfører struktur. Det betyder med andre ord, at man med tagging opbygger "fool proof" RT-"tesauris" der ikke kan andet end at passe med brugerens egne forventninger - pånår et fåtal af regler der skal overholdes; For det første skal man bruge samme tagging-konvention hver gang, for det andet må man ikke "tagge over tid", da man kan risikere at ændre mening. Da det selvfølgelig er umuligt at lade være med at tagge over tid, vil dette være en fejlkilde man skal tage med - altså, at man skifter mening mht. tags, eller at dokumenter pludselig ses i en anden kontekst.

Pointen med indhold der medfører struktur ér, at man vil kunne se på disse strukturer som en form for "tilkendegivelse" af "aboutness" - men "aboutness" ud fra en subjektiv kontekst. Det vil altså være muligt at sammenligne den kontekst-basede "aboutness" med f.eks. den "objektive" biblioteks-struktur, eller måske foretage en undersøgelse af hvordan "aboutness" eller "summary" begrebet passer sammen med f.eks. en "Automatic Summary Mechanism", f.eks. Extractor.